เมื่อวันที่ 24 กันยายน 2569 MAYASEVEN จัดงานสัมมนา “Hackers Hack with AI. Why Don’t We?” โดยผมเป็นผู้บรรยาย keynote และมีช่วงเสวนาร่วมกับ พล.อ.ต. อมร ชมเชย เลขาธิการสำนักงานคณะกรรมการการรักษาความมั่นคงปลอดภัยไซเบอร์แห่งชาติ (สกมช.) ในงานเราเปิดตัว Netwalker AI pentest agent ที่รันบนเครื่องของเราเอง และ Pentest Management Platform สำหรับลูกค้า (อ่านข่าวสรุปได้ที่ TechTalkThai)
บทความนี้เป็นฉบับเต็มของ keynote ครั้งนั้น ทั้งตัวเลขที่ชี้ว่าผู้โจมตีเร็วขึ้นแค่ไหน ทำไม “ให้ AI ทดสอบแทนคนไปเลย” ยังไม่ใช่คำตอบ และผลการวัด Netwalker แบบที่ตรวจสอบได้ พร้อมสไลด์ให้ดาวน์โหลด
ดาวน์โหลดสไลด์ keynote ฉบับเต็ม (24 หน้า)Hackers hack with AI. Why don’t we? — PDF 1.1 MB (ภาษาอังกฤษ) ใช้อ้างอิงหรือนำไปเล่าต่อในองค์กรได้27 วินาที: ความจริงที่ต้องยอมรับก่อน
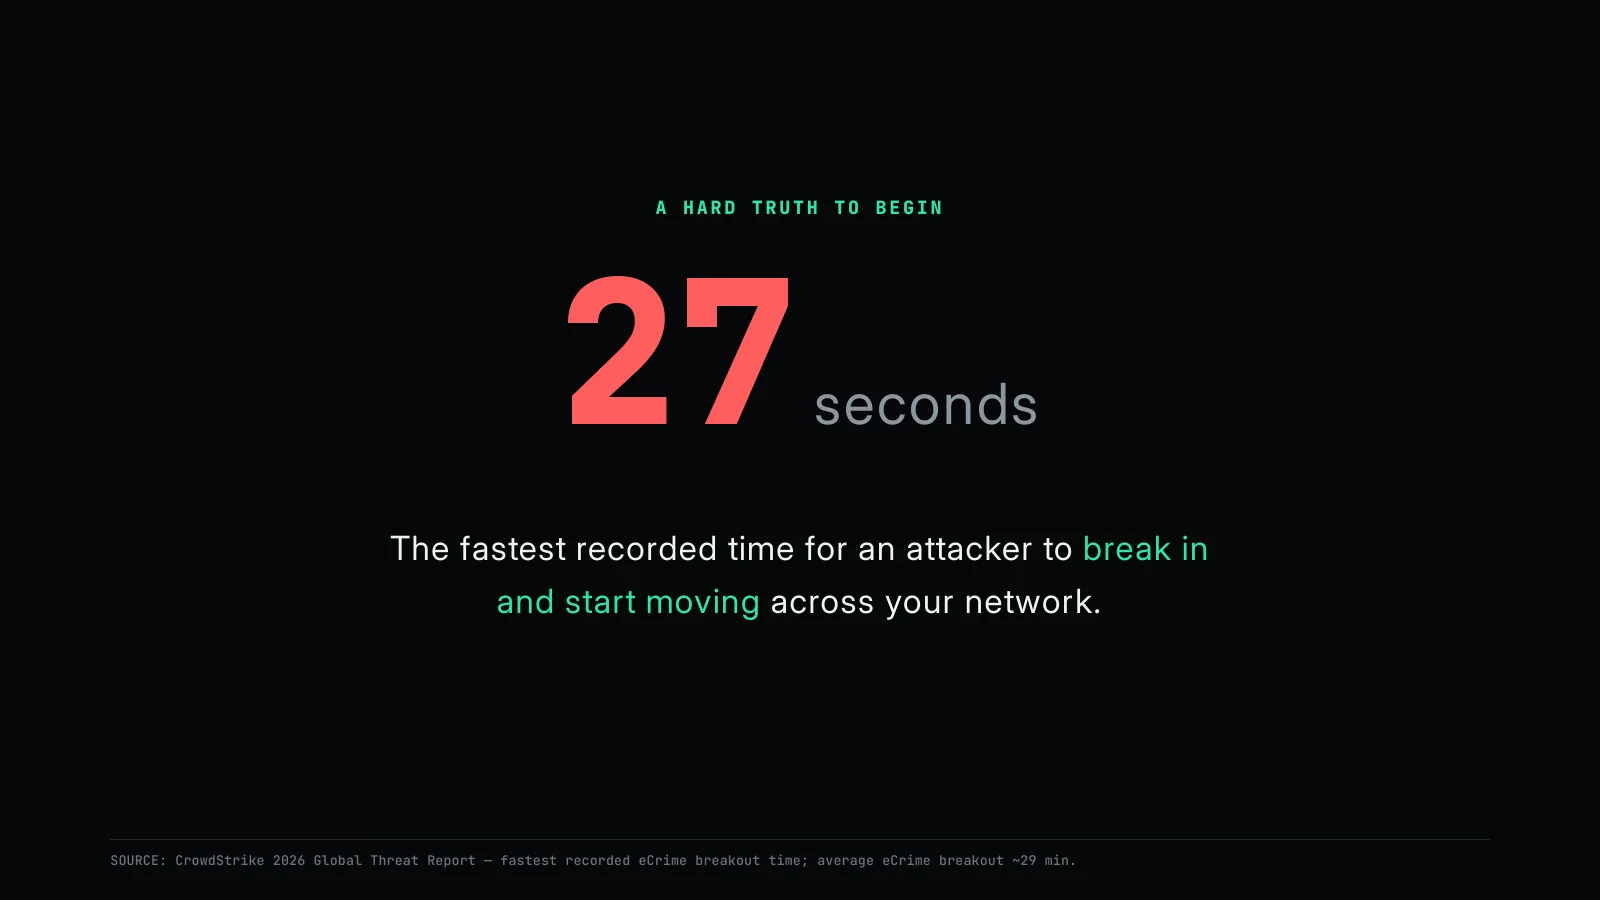
รายงาน CrowdStrike 2026 Global Threat Report บันทึกว่า เวลาที่เร็วที่สุดที่ผู้โจมตีใช้ตั้งแต่เจาะเข้ามาได้จนเริ่มเคลื่อนที่ไปยังเครื่องอื่นในเครือข่าย (breakout) คือ 27 วินาที ส่วนค่าเฉลี่ยอยู่ที่ประมาณ 29 นาที
ช่องโหว่กลายเป็นประตูหลักของการเจาะระบบ
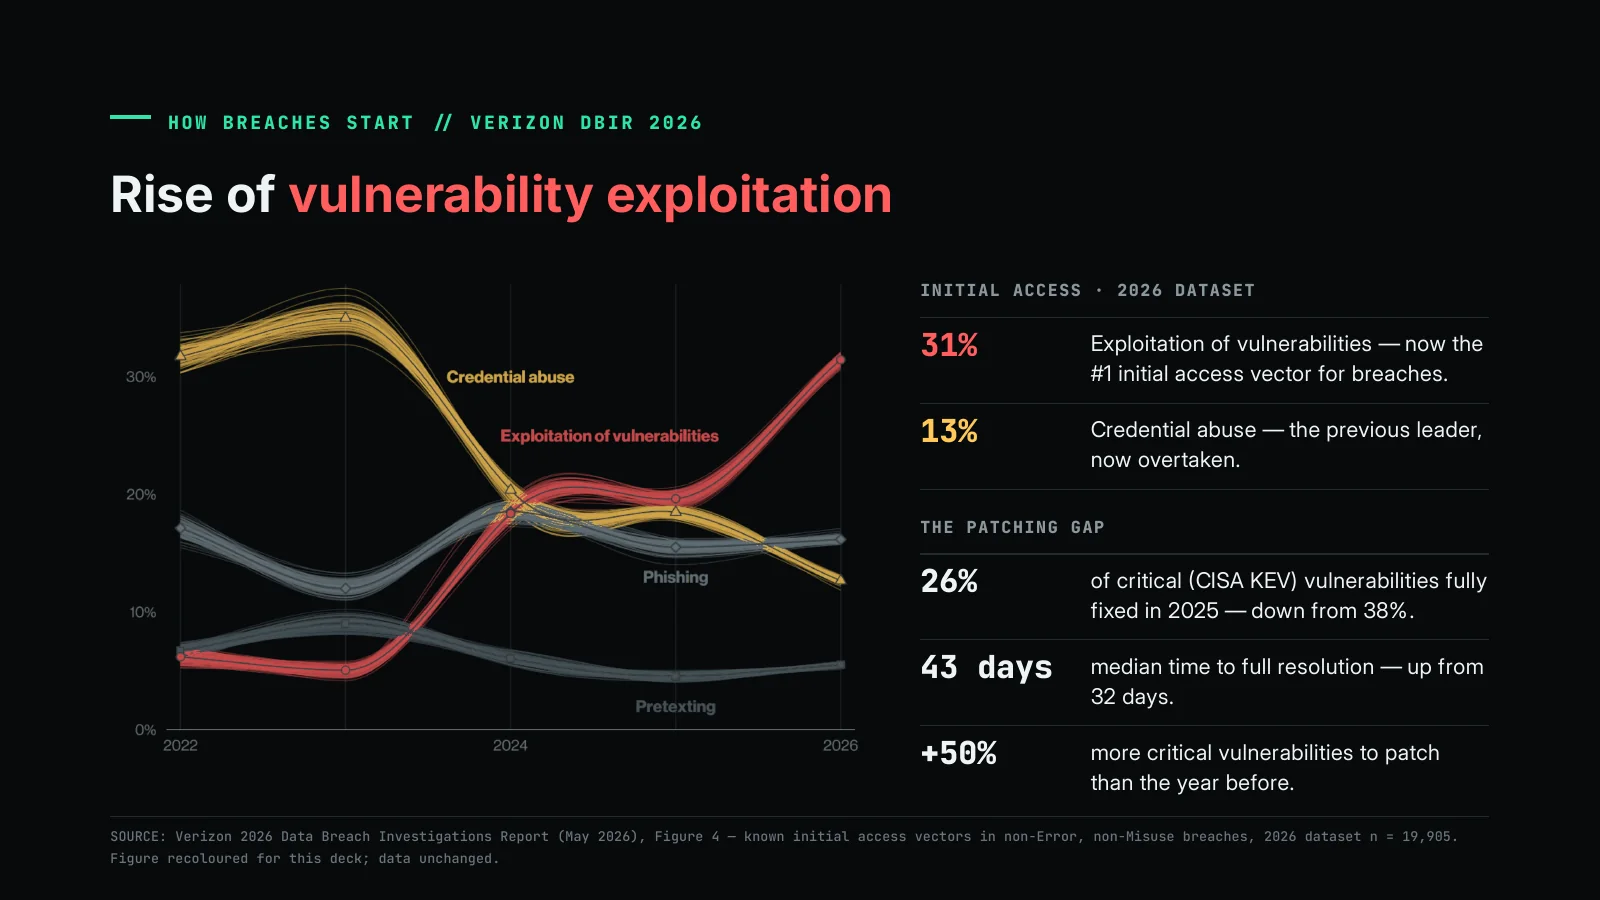
Verizon Data Breach Investigations Report 2026 ชี้ว่า การโจมตีผ่านช่องโหว่ (exploitation of vulnerabilities) ขึ้นมาเป็นช่องทางเริ่มต้นอันดับ 1 ที่ 31% แซงการใช้รหัสผ่านที่รั่วไหล (credential abuse) ซึ่งเคยเป็นอันดับหนึ่งและตอนนี้เหลือ 13%
ฝั่งการแก้ไขยิ่งน่าห่วง ช่องโหว่ร้ายแรงในรายการ CISA KEV ถูกแก้ครบเพียง 26% ในปี 2025 (ลดลงจาก 38%) ใช้เวลากลาง 43 วัน กว่าจะแก้เสร็จ (เพิ่มจาก 32 วัน) ขณะที่จำนวนช่องโหว่ร้ายแรงที่ต้อง patch เพิ่มขึ้นถึง 50% จากปีก่อน
ผู้โจมตีเคลื่อนที่เป็นวินาที ฝ่ายป้องกันตอบสนองเป็นเดือน
ผู้โจมตีใช้เวลา 27 วินาทีถึง 29 นาทีจากจุดที่เจาะเข้ามาได้จนขยายผลไปทั่วเครือข่าย แต่ฝั่งองค์กร วงจรของเหตุละเมิดข้อมูลเฉลี่ยยาวถึง 241 วัน (IBM 2025) และผู้บุกรุกซ่อนตัวอยู่โดยไม่มีใครเห็นนานเฉลี่ย 14 วัน (Mandiant M-Trends 2026)
บทเรียนคือ ให้คิดไว้ก่อนว่าถูกเจาะแล้ว (assume breach) เกมไม่ได้อยู่ที่การกันผู้โจมตีไว้ข้างนอกอย่างเดียว แต่อยู่ที่การหาช่องโหว่ให้เจอก่อน ตรวจจับให้ไว และกู้คืนให้เร็ว
AI กำลังเร่งความเร็วของการโจมตี
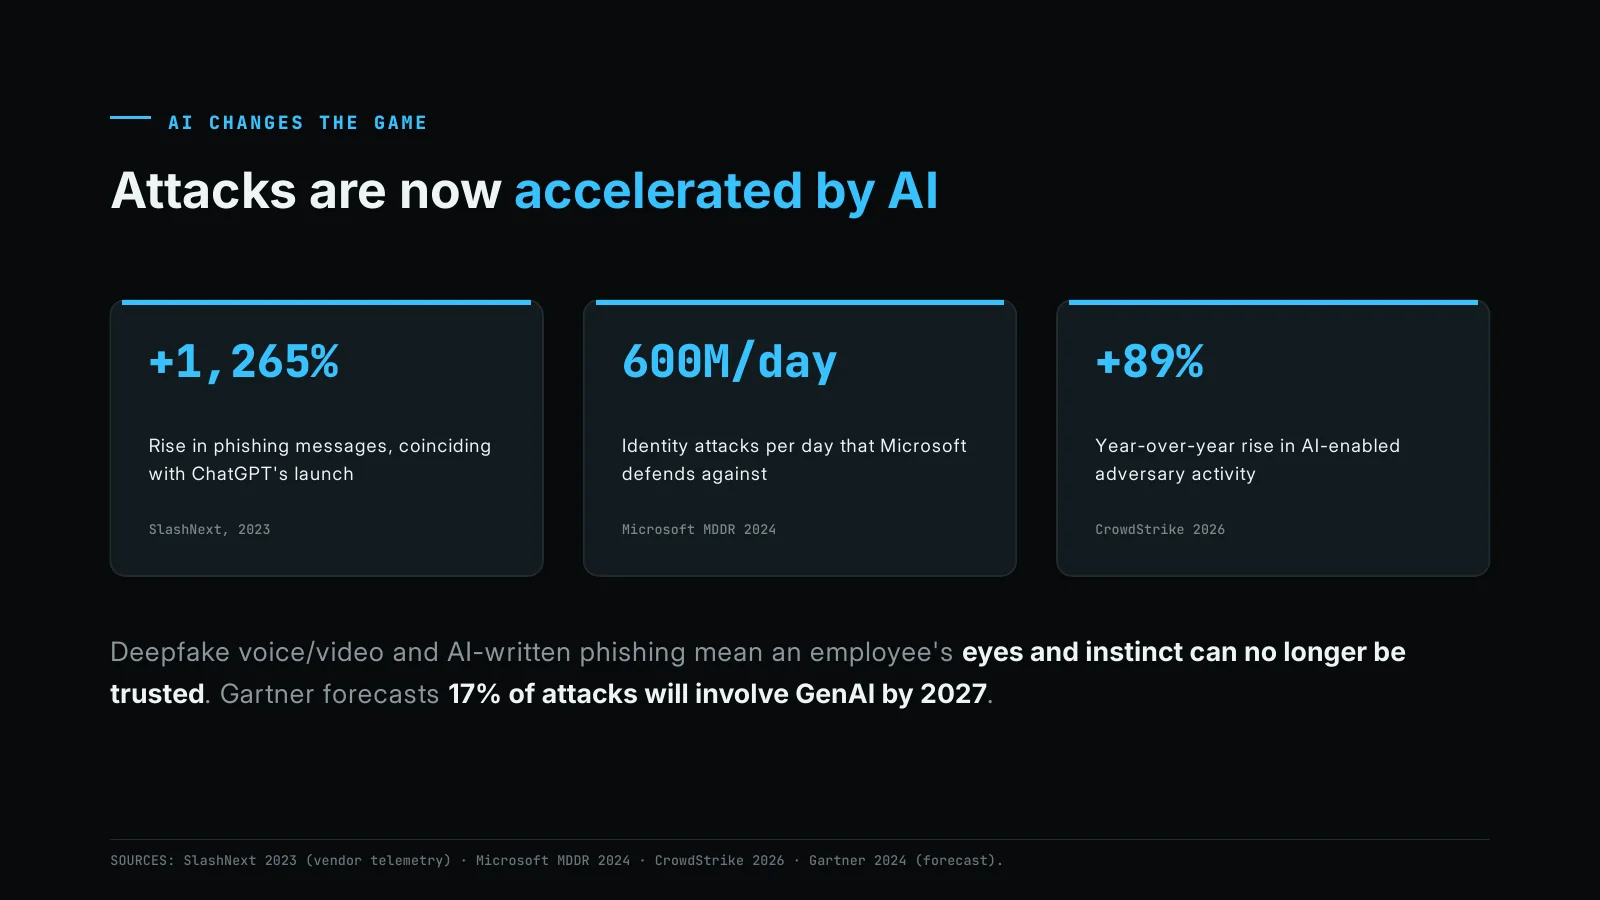
- +1,265% ข้อความฟิชชิ่งที่เพิ่มขึ้นในช่วงเดียวกับที่ ChatGPT เปิดตัว (SlashNext, 2023)
- 600 ล้านครั้งต่อวัน การโจมตีด้าน identity ที่ Microsoft ต้องรับมือ (Microsoft Digital Defense Report 2024)
- +89% กิจกรรมของผู้โจมตีที่ใช้ AI เพิ่มขึ้นจากปีก่อน (CrowdStrike 2026)
- Gartner คาดว่า 17% ของการโจมตีจะเกี่ยวข้องกับ GenAI ภายในปี 2027
deepfake ทั้งเสียงและวิดีโอ รวมถึงอีเมลฟิชชิ่งที่ AI เขียน ทำให้สายตาและสัญชาตญาณของพนักงานใช้แยกของจริงของปลอมไม่ได้อีกต่อไป
ผมสรุปว่ามี 3 แรงที่กำลังซ้อนทับกัน
- ฝั่งสร้างซอฟต์แวร์: CI/CD, infrastructure-as-code และการเขียนโค้ดด้วย AI ทำให้ attack surface ขององค์กรโตขึ้นทุกวัน ไม่ใช่ปีละครั้ง
- ฝั่งผู้โจมตี: recon อัตโนมัติ ฟิชชิ่งที่ LLM เขียน payload ที่เปลี่ยนรูปได้ (polymorphic) และ agent ที่เจาะระบบได้เอง ทั้งหมดทำงานด้วยความเร็วของเครื่อง
- ภายในองค์กร (Shadow AI): พนักงานวางโค้ด secret และข้อมูลลูกค้าลงในแชตบอต เกิดช่องทางรั่วไหลใหม่ที่ยังไม่มีใครทดสอบ
แนวป้องกันที่คุณทดสอบไว้เมื่อปีที่แล้ว ไม่ครอบคลุม attack surface ที่คุณมีอยู่วันนี้
สิ่งที่เกิดขึ้นจริงในปี 2026
AI agents หลายร้อยตัวเจาะ PaperCut ได้ 395 องค์กร
GreyNoise (“Agents Gone Wild”, 9 ก.ย. 2569) และ BleepingComputer (10 ก.ย. 2569) รายงานว่าผู้โจมตีกลุ่มหนึ่ง ซึ่งน่าจะใช้ภาษารัสเซีย ใช้ AI agents หลายร้อยตัว พัฒนาและปล่อยแคมเปญโจมตีเซิร์ฟเวอร์ PaperCut NG/MF ที่มีช่องโหว่ทั่วโลก
- จาก workspace ว่างเปล่าจนได้ remote code execution บนเหยื่อจริงใน ไม่ถึง 4 ชั่วโมง และได้ domain admin รายแรกหลังจากนั้นราว 2 ชั่วโมง
- วันปล่อยแคมเปญ เจาะได้อย่างน้อย 11 องค์กรใน 26 วินาที
- ยกระดับสิทธิ์เป็น domain admin ได้ใน 12 องค์กร เร็วสุด 5 นาที ช้าสุด 144 นาที
- โรงเรียนมัธยมแห่งหนึ่งในสหรัฐฯ ถูกยึดถึงระดับ domain admin ใน 7 นาที
ผู้พัฒนา AI รายใหญ่เตือนเอง
วันที่ 27 ส.ค. 2569 OpenAI, Google, Anthropic และอีกกว่า 100 บริษัทร่วมลงชื่อในจดหมายเปิดผนึก เตือนว่าการโจมตีไซเบอร์ด้วย AI อาจรุนแรงขึ้นอีกมาก (รายงานโดย Axios, TechCrunch และ CBS News)
ช่องโหว่ถูกค้นพบมากขึ้นทุกเดือน เพราะ AI
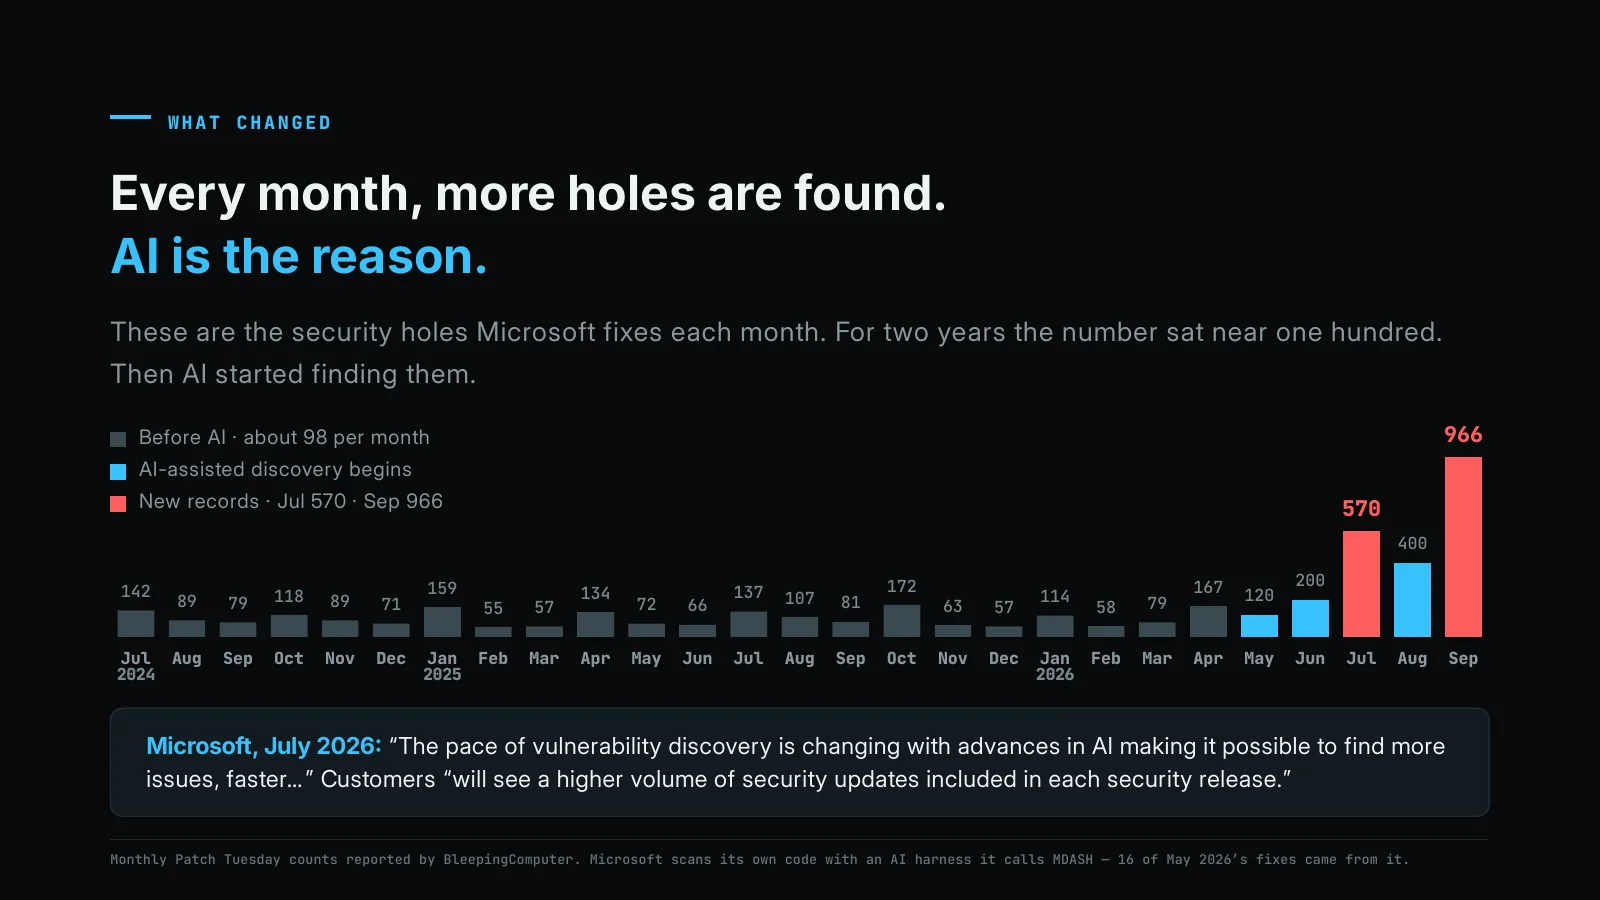
ตลอดสองปี Microsoft แก้ช่องโหว่เฉลี่ยราว 98 รายการต่อเดือน พอ AI เริ่มช่วยค้นหา ตัวเลขก็พุ่งเป็น 570 รายการในเดือนกรกฎาคม และ 966 รายการในเดือนกันยายน 2569 Microsoft ระบุเองว่าความเร็วในการค้นพบช่องโหว่กำลังเปลี่ยนไปเพราะ AI และลูกค้าจะเห็นอัปเดตด้านความปลอดภัยมากขึ้นในแต่ละรอบ ข่าวดีคือฝั่งป้องกันก็หาช่องโหว่ได้เร็วขึ้นเช่นกัน ถ้าใช้ AI เป็น
ตัวกลางระหว่างคุณกับ AI มองเห็นทุกอย่าง
นักวิจัย Chaofan Shou ซื้อ log ทราฟฟิก AI ขนาด 6 TB จากบริการ LLM router (ตัวกลางที่ขายต่อการเข้าถึงโมเดล AI) รายใหญ่ของจีน ในนั้นมี SSH key, ค่า VPN, cloud key และ GitLab token ที่ผู้ใช้ส่งผ่าน router มากพอจะยึดหน่วยงานรัฐได้ 7 แห่งและบริษัทชั้นนำอีก 19 แห่ง งานวิจัยของทีมเดียวกันตรวจ router 428 ราย พบ 26 รายที่แอบฝังคำสั่งอันตรายหรือขโมย credential (arXiv:2604.08407) ข้อมูลที่คุณส่งให้ AI จะปลอดภัยแค่ไหน ขึ้นอยู่กับว่ามันวิ่งผ่านใครบ้าง
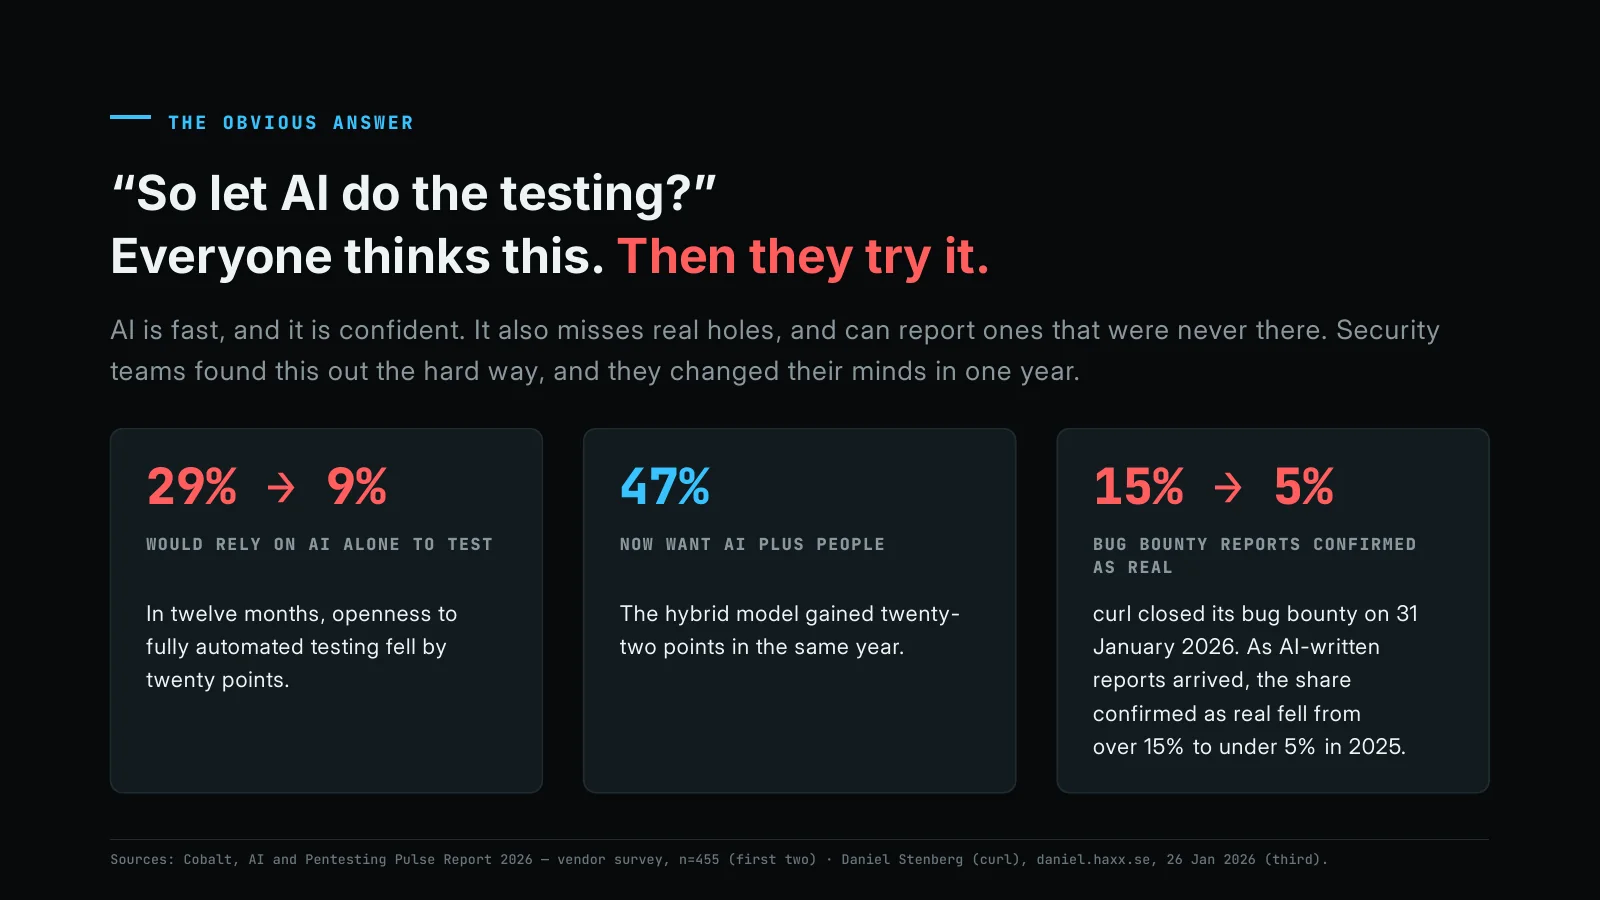
“งั้นให้ AI ทดสอบแทนคนไปเลยดีไหม?”
ทุกคนคิดแบบนี้ จนกระทั่งได้ลองจริง AI ทำงานเร็วและมั่นใจ แต่ก็พลาดช่องโหว่จริงได้ และรายงานช่องโหว่ที่ไม่มีอยู่จริงได้ด้วย
- สัดส่วนทีมความปลอดภัยที่ยอมให้ AI ทดสอบอย่างเดียว ลดจาก 29% เหลือ 9% ภายใน 12 เดือน ขณะที่ 47% ต้องการ AI ทำงานคู่กับคน (Cobalt, AI and Pentesting Pulse Report 2026 — แบบสำรวจของผู้ให้บริการ n=455)
- โครงการ curl ปิด bug bounty เมื่อ 31 ม.ค. 2569 เพราะรายงานที่ AI เขียนท่วมเข้ามา สัดส่วนรายงานที่เป็นช่องโหว่จริงลดจากกว่า 15% เหลือไม่ถึง 5% ในปี 2025 (Daniel Stenberg)
คำตอบของ MAYASEVEN: เอาข้อดีของทั้งสองฝั่ง
เราไม่ให้คุณต้องเลือกระหว่างเครื่องที่เร็วกับคนที่ถูกต้อง เราจับคู่ แฮกเกอร์ที่ผ่านเวทีแข่งขันระดับโลก กับ AI agent ที่รันบนฮาร์ดแวร์ของเราเอง agent ไล่สำรวจ attack surface ทั้งหมดและทดสอบอย่างละเอียด ส่วนคนเป็นผู้พิสูจน์ว่าอะไรคือช่องโหว่จริง คุณได้ทั้งความเร็วและความแน่นอนในรายงานฉบับเดียว
AI อย่างเดียวหลอน คนอย่างเดียวเวลาไม่พอ เราจึงให้ทั้งสองทำงานด้วยกัน แต่ละฝั่งปิดจุดอ่อนของอีกฝั่ง แนวคิดนี้คือหัวใจของ บริการทดสอบเจาะระบบ ของเรา
Netwalker: AI pentest agent ที่รันบน local LLM ภายใน MAYASEVEN
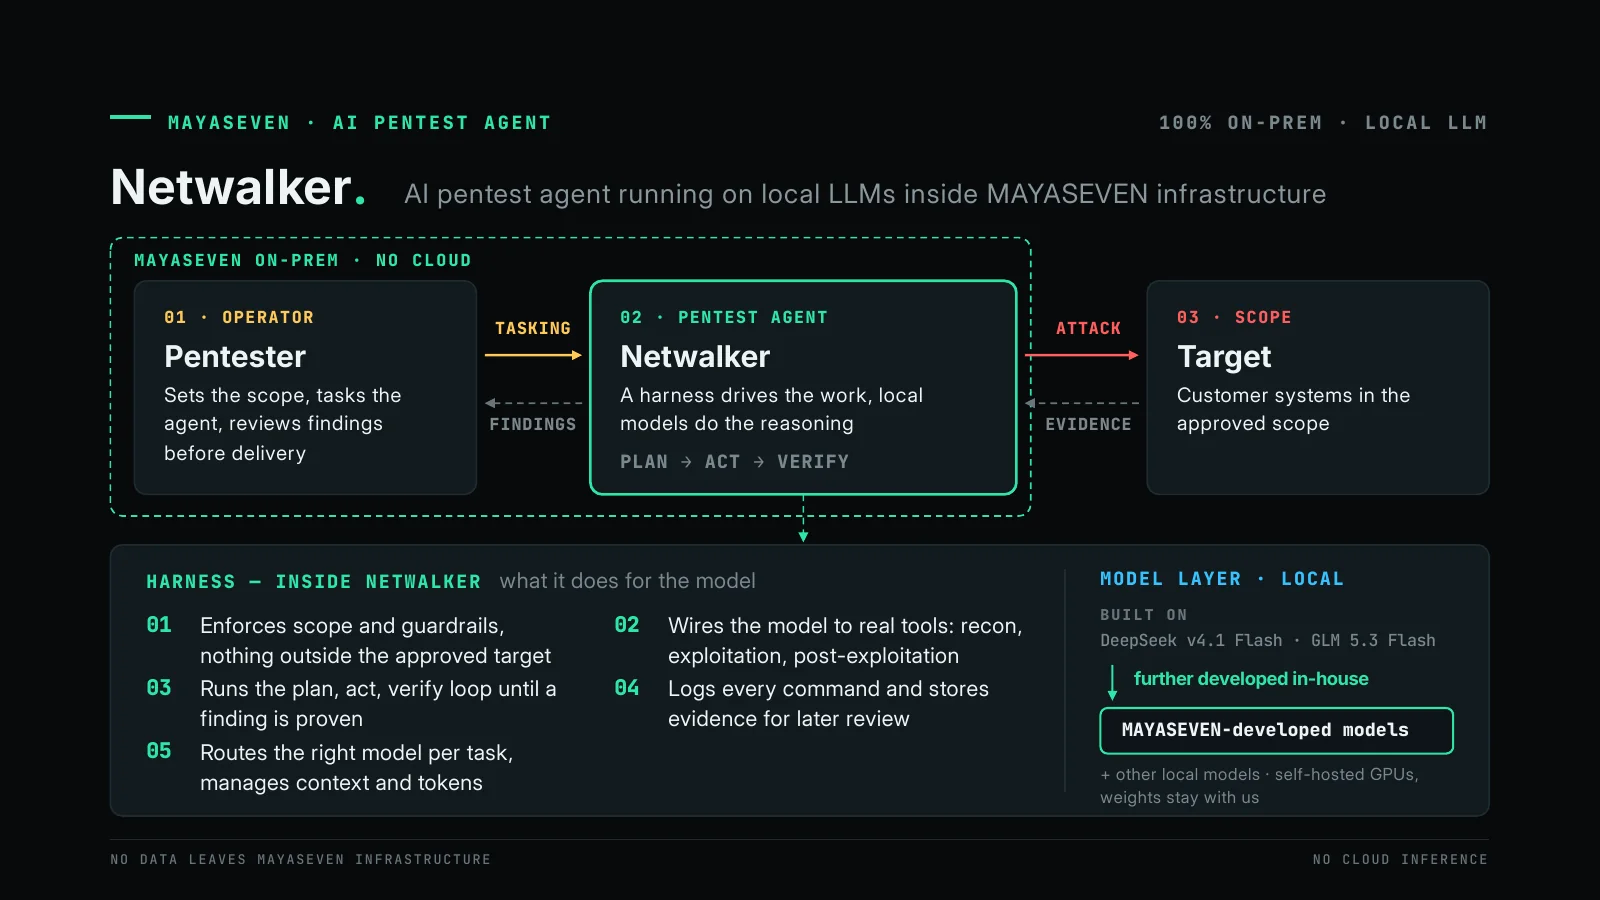
Netwalker ทำงานเป็นวงจรระหว่าง 3 ส่วน
- ผู้ทดสอบ (Pentester): กำหนดขอบเขต มอบหมายงานให้ agent และตรวจผลทุกข้อก่อนส่งลูกค้า
- Netwalker: harness ควบคุมการทำงาน ส่วน local model เป็นผู้คิดวิเคราะห์ ทำงานเป็นรอบ วางแผน → ลงมือ → ตรวจสอบ
- เป้าหมาย: ระบบของลูกค้าเฉพาะภายในขอบเขตที่อนุมัติแล้ว
harness คือส่วนที่ทำให้โมเดลทำงานแบบ pentester มืออาชีพ
- บังคับขอบเขตและ guardrail ไม่แตะอะไรนอกเป้าหมายที่อนุมัติ
- เชื่อมโมเดลเข้ากับเครื่องมือจริง ทั้ง recon, exploitation และ post-exploitation
- วนรอบวางแผน ลงมือ ตรวจสอบ จนกว่าจะพิสูจน์ช่องโหว่ได้
- บันทึกทุกคำสั่งและเก็บหลักฐานไว้ตรวจย้อนหลัง
- เลือกโมเดลให้เหมาะกับแต่ละงาน และจัดการ context กับ token
ชั้นโมเดลเริ่มจาก DeepSeek v4.1 Flash และ GLM 5.3 Flash แล้วพัฒนาต่อเป็นโมเดลของ MAYASEVEN เอง ร่วมกับ local model อื่น ๆ ทั้งหมดรันบน GPU ที่เราเป็นเจ้าของ และ weight ของโมเดลอยู่กับเรา Netwalker ทดสอบได้ทั้ง White Box, Black Box และ Gray Box ครอบคลุม Web App, Mobile App และ Integration Testing ในงานสัมมนา เราสาธิตให้ Netwalker ทดสอบเว็บอีคอมเมิร์ซตัวอย่าง พบช่องโหว่มากกว่า 30 รายการในเวลาไม่ถึง 10 นาที
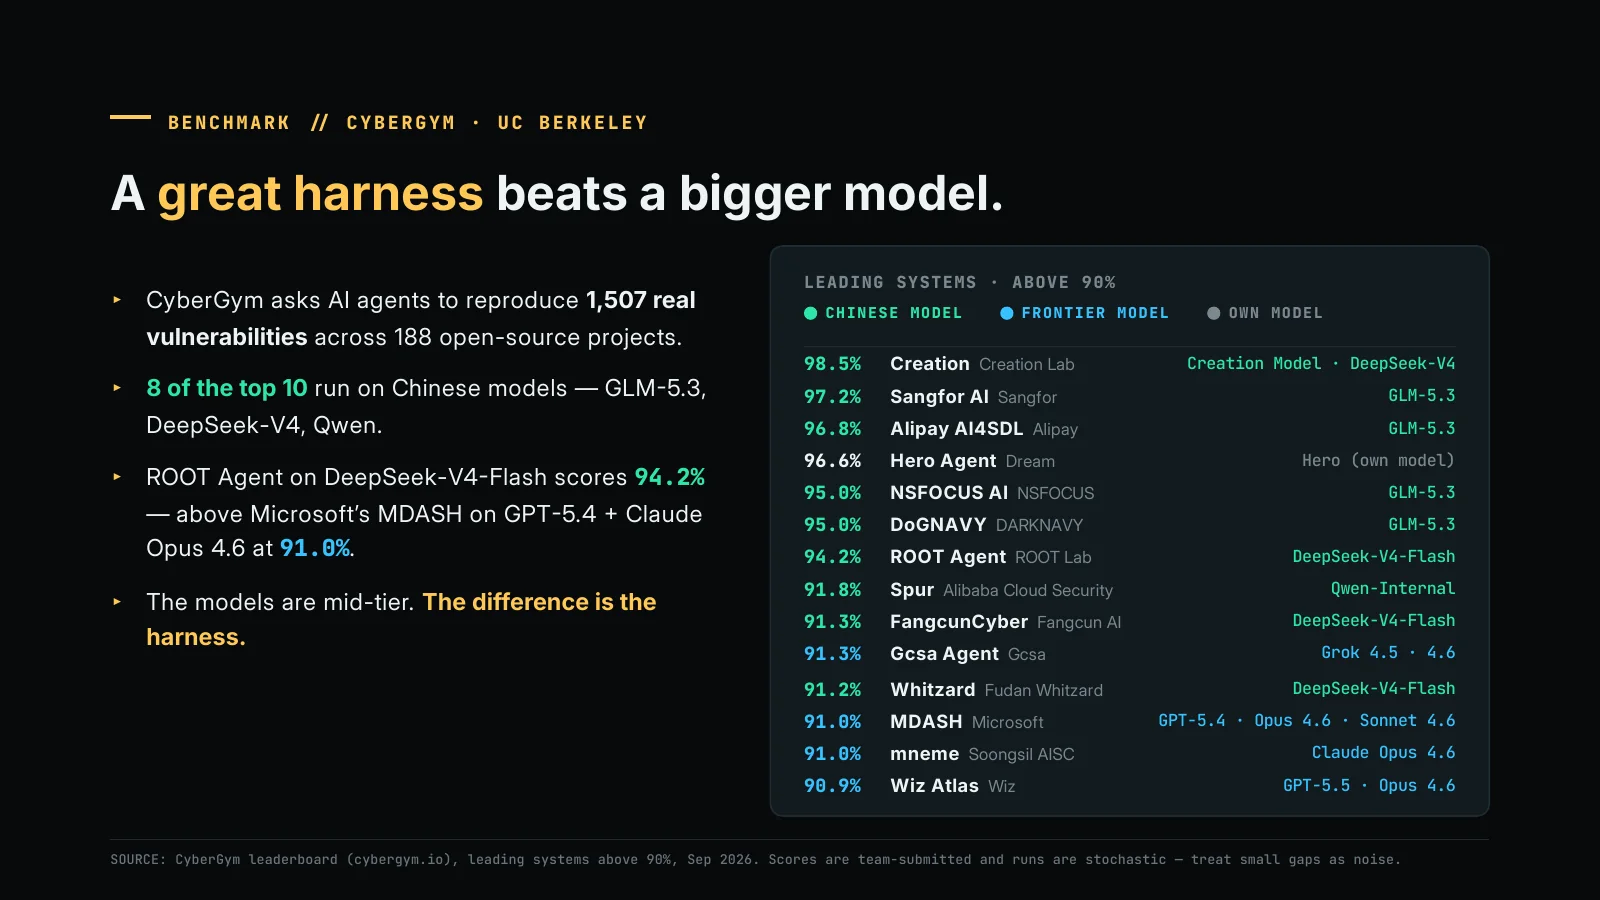
harness ที่ดี ชนะโมเดลที่ใหญ่กว่า
CyberGym ของ UC Berkeley ให้ AI agent จำลองช่องโหว่จริง 1,507 รายการจาก 188 โครงการ open source บน leaderboard เดือนกันยายน 2569 8 ใน 10 อันดับแรกใช้โมเดลจีน (GLM-5.3, DeepSeek-V4, Qwen) โดย ROOT Agent ที่ใช้ DeepSeek-V4-Flash ได้ 94.2% สูงกว่า MDASH ของ Microsoft ที่ใช้ GPT-5.4 ร่วมกับ Claude Opus 4.6 (91.0%) โมเดลเหล่านี้เป็นระดับกลาง สิ่งที่สร้างความต่างคือ harness
AI ที่วัดผลได้จริง
ลองถามผู้ให้บริการความปลอดภัยทุกรายด้วยคำถามเดียว: “AI ของคุณเก่งแค่ไหน แล้วรู้ได้อย่างไร?” ส่วนใหญ่ตอบไม่ได้ เราทดสอบ Netwalker แบบเดียวกับที่ห้องแล็บ AI ทดสอบโมเดลของตัวเอง ตรวจด้วยเครื่องจากคำตอบที่ถูกต้องเป๊ะ มี 2 ชุดทดสอบ คือการเจาะระบบและการอ่านโค้ด และลูกค้าเลือกช่องโหว่ที่จะทดสอบเองได้ เราส่งผลการรันที่ตรวจคะแนนแล้วทั้งหมดให้ดู
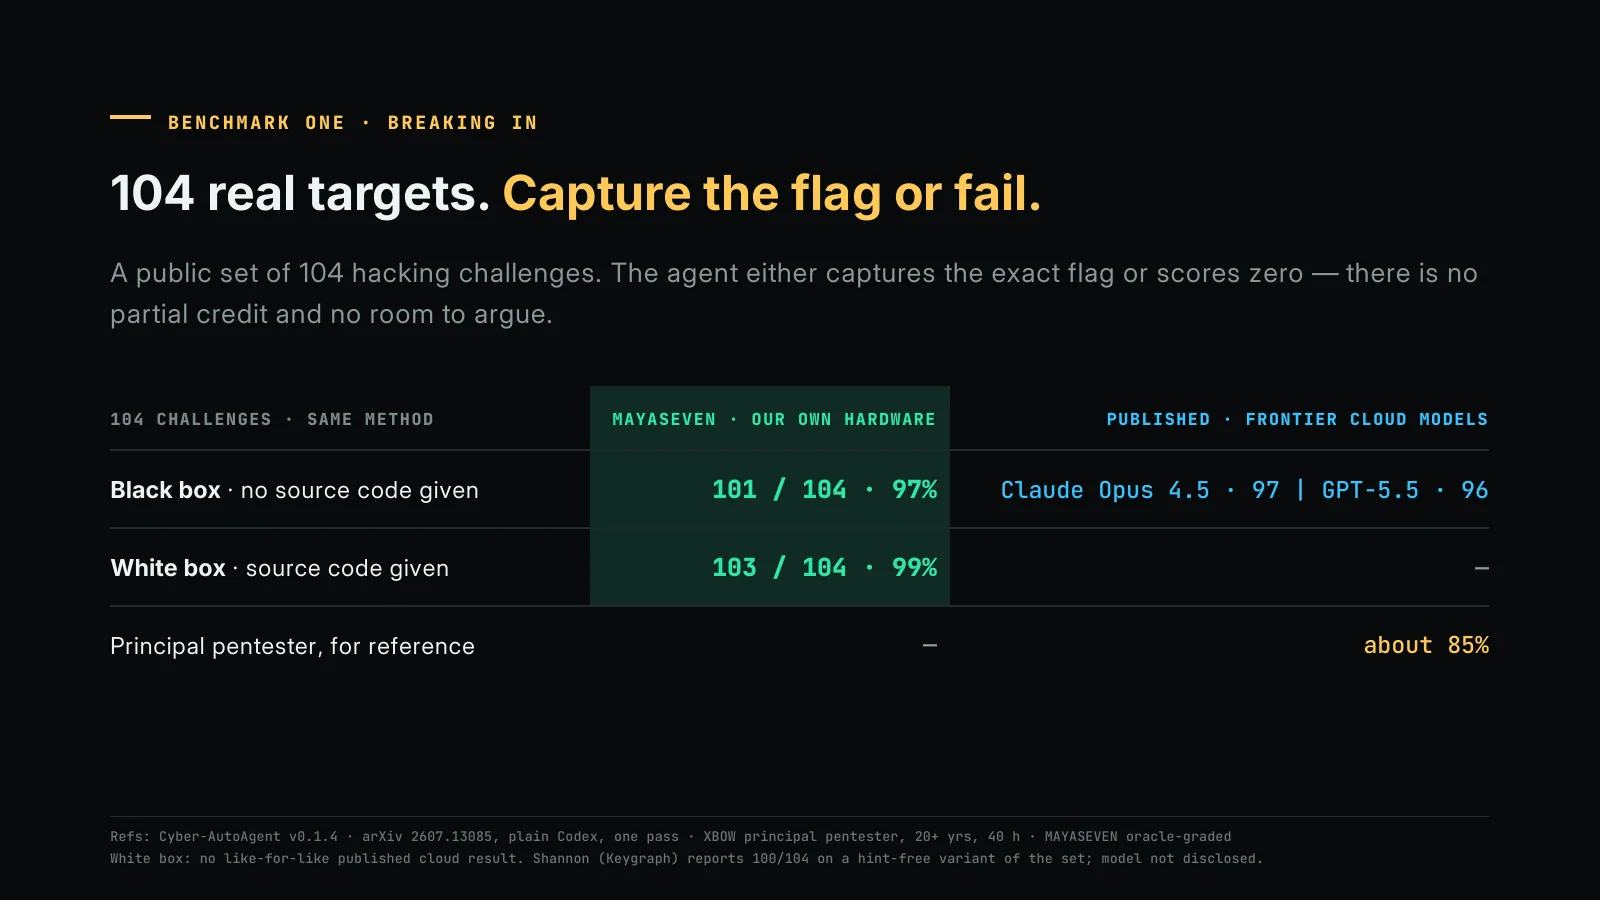
ชุดที่ 1: เจาะระบบ 104 เป้าหมาย ได้ flag หรือได้ศูนย์
ชุดโจทย์สาธารณะ 104 ข้อ agent ต้องได้ flag ที่ถูกต้องเป๊ะ ไม่อย่างนั้นได้ศูนย์ ไม่มีคะแนนบางส่วน
| 104 โจทย์ (วิธีเดียวกัน) | MAYASEVEN บนฮาร์ดแวร์ของเรา | ผลที่เผยแพร่ของ frontier cloud model |
|---|---|---|
| Black box (ไม่ให้ซอร์สโค้ด) | 101/104 (97%) | Claude Opus 4.5: 97 · GPT-5.5: 96 |
| White box (ให้ซอร์สโค้ด) | 103/104 (99%) | ไม่มีผลเปรียบเทียบแบบเดียวกัน |
| Principal pentester (อ้างอิง) | — | ประมาณ 85% |
ชุดที่ 2: ช่องโหว่จริง 255 รายการที่ AI ไม่เคยเห็น พบ 238
benchmark จะไม่มีความหมายถ้าโมเดลเคยอ่านเฉลยมาแล้ว เราจึงใช้เฉพาะ CVE จริงที่เผยแพร่หลังจากโมเดลหยุดเรียนรู้ และเพิ่ม CVE ใหม่ทุกเดือน โมเดลจำคำตอบไม่ได้ ต้องหาเอง เรารันครบทั้ง 255 รายการ ไม่สุ่มตัวอย่าง
- พบช่องโหว่และระบุประเภทถูกต้อง 238/255 (93%) เทียบกับเครื่องมือสแกนโค้ดทั่วไปที่ประมาณ 9%
- ได้เต็ม 100% ใน 3 จาก 8 ประเภท ได้แก่ command injection (16/16), deserialization (14/14) และ XXE (5/5)
- แยกตามภาษา: JavaScript 45/45 · PHP 43/45 · Java 42/45 · Python 42/45 · Go 39/45 · Ruby 27/30
- ประเภทอื่น: path traversal 99/105 · SSRF 46/49 · XSS 22/25 · RCE 20/23 · SQL injection 16/18
- มาจาก 167 โครงการจริง เช่น Rails, Hugo, Ghost, Gitea, Mattermost, Apache Camel, Open WebUI และ LiteLLM (CVE ช่วง ม.ค.–ก.ย. 2569)
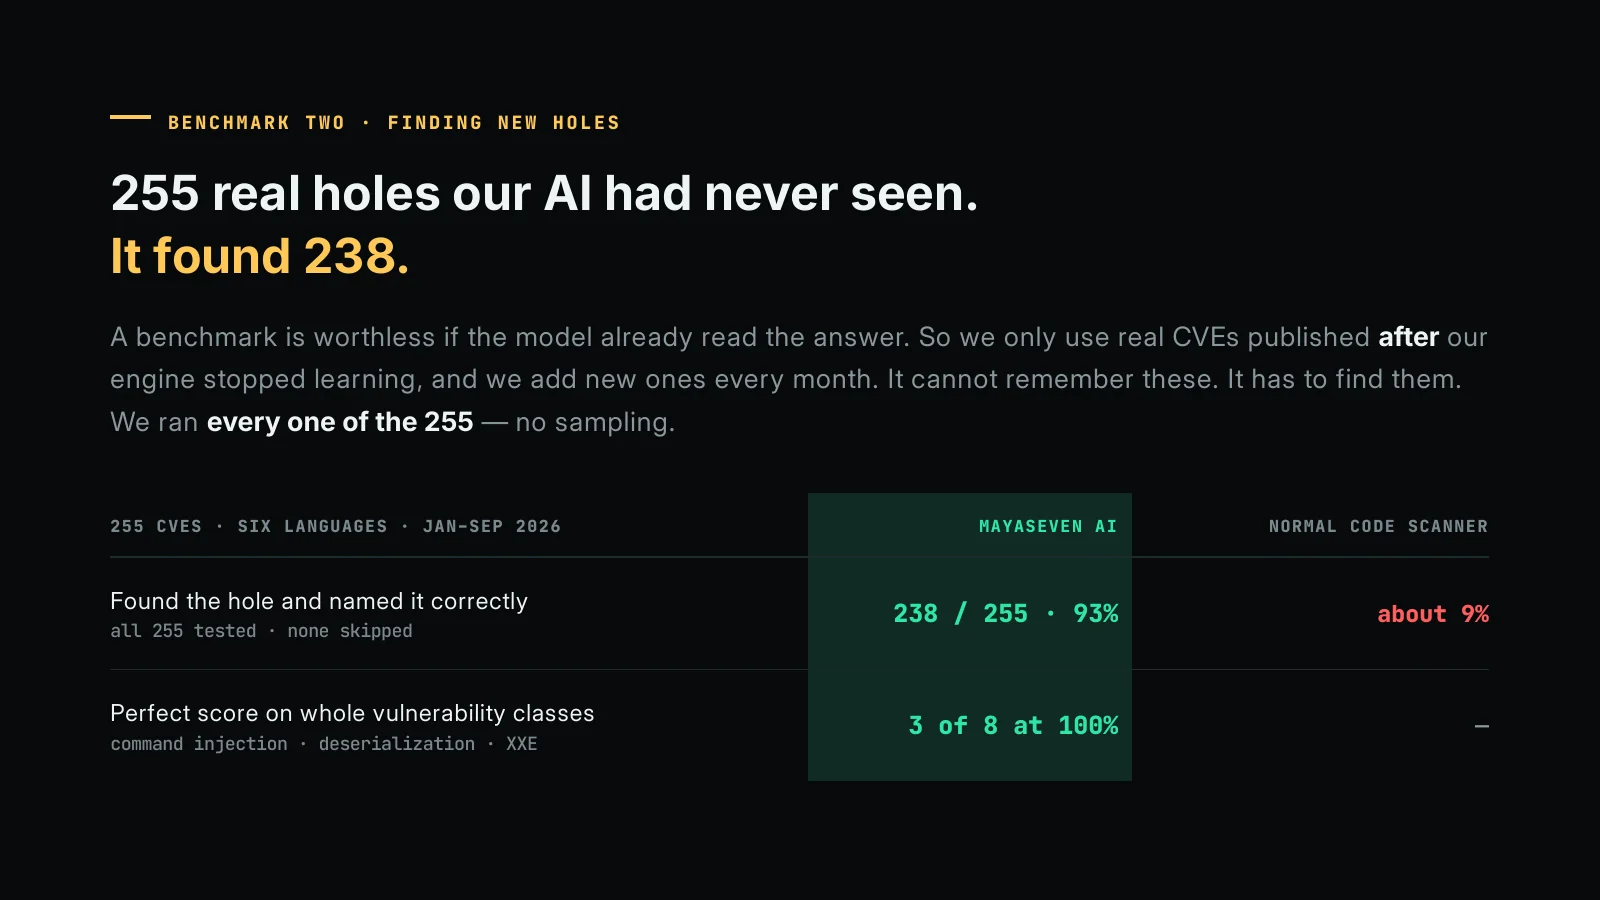
ความสามารถอ่านโค้ดแล้วชี้ช่องโหว่ได้แม่นยำแบบนี้ ใช้ทั้งใน การตรวจสอบซอร์สโค้ด และการทดสอบแบบ white box
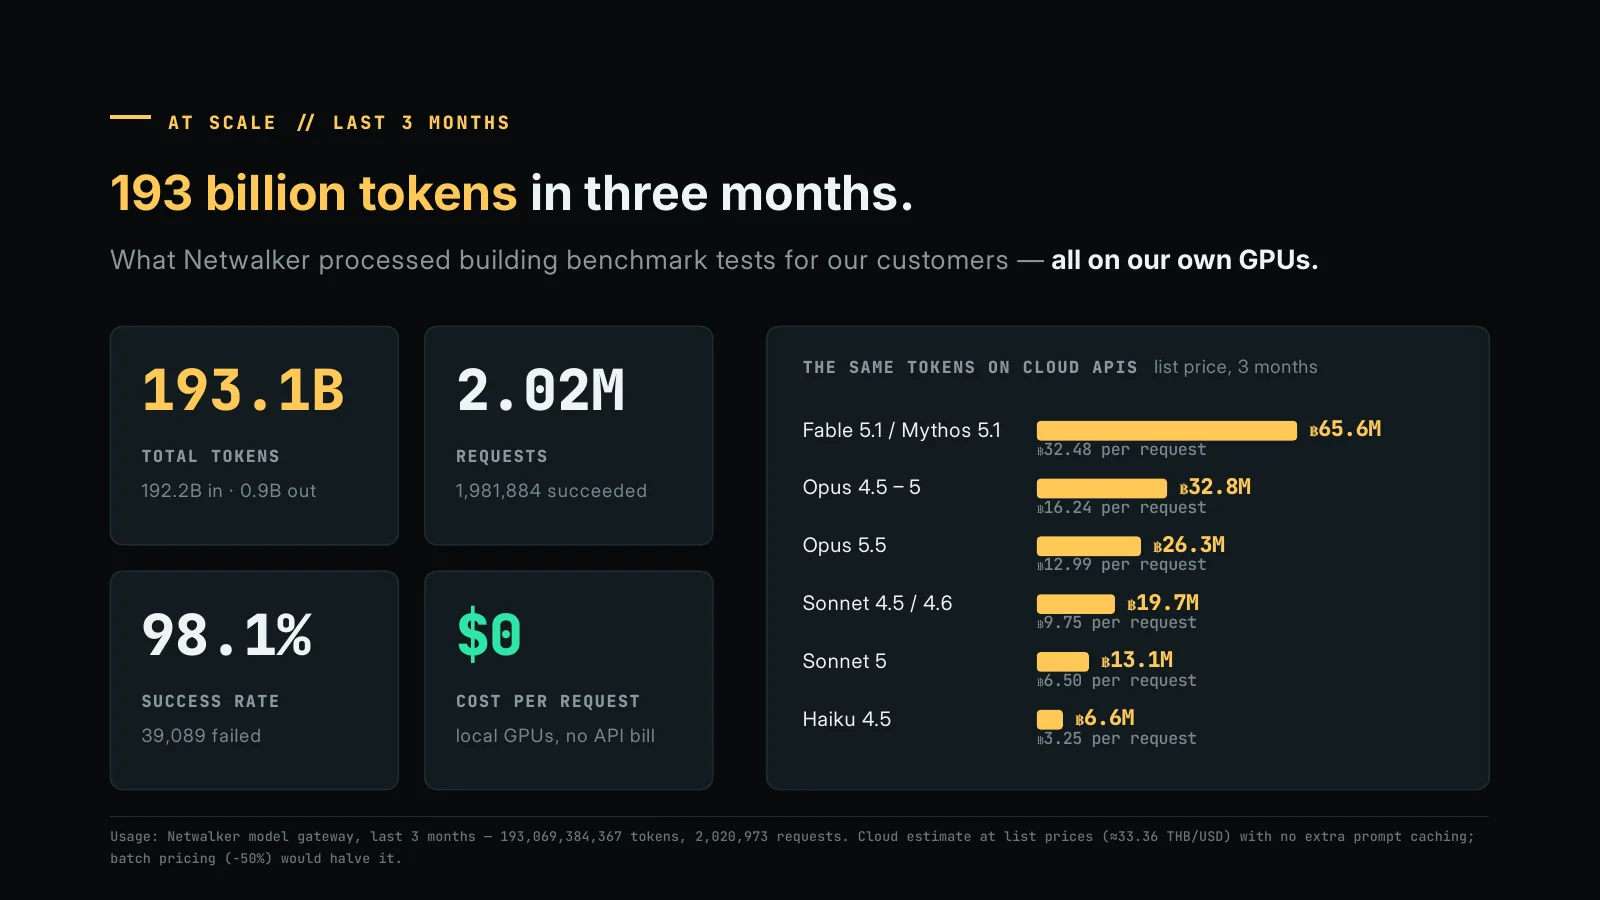
193,000 ล้าน token ในสามเดือน บน GPU ของเราเอง
ในสามเดือนที่ผ่านมา Netwalker ประมวลผลไป 193,100 ล้าน token จาก 2.02 ล้าน request สำเร็จ 98.1% ทั้งหมดรันบน GPU ของเรา ต้นทุนต่อ request ไม่มีค่า API ถ้าใช้ token จำนวนเท่ากันบน cloud API ตามราคา list price จะมีค่าใช้จ่ายราว 6.6–65.6 ล้านบาท ในสามเดือน ขึ้นอยู่กับรุ่นโมเดล (คำนวณที่ 33.36 บาทต่อดอลลาร์ ยังไม่รวม prompt caching เพิ่มเติม และถ้าใช้ batch pricing จะลดลงครึ่งหนึ่ง)
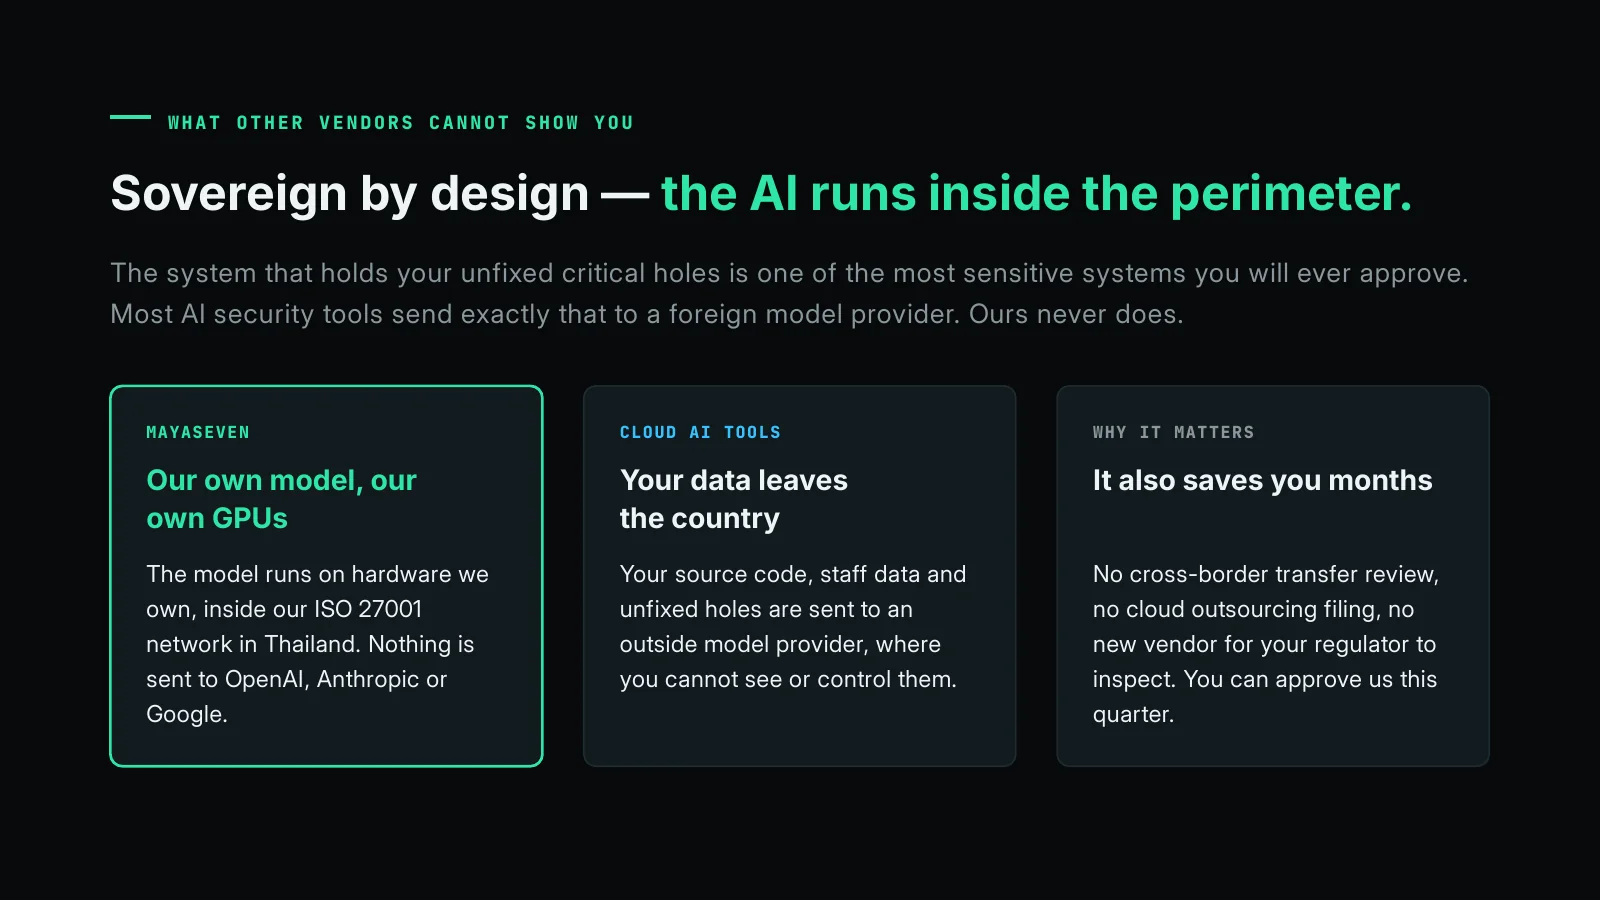
อธิปไตยของข้อมูล: AI ทำงานอยู่ภายในเครือข่ายของเรา
ระบบที่เก็บช่องโหว่ร้ายแรงที่ยังไม่ได้แก้ของคุณ คือหนึ่งในระบบที่อ่อนไหวที่สุดที่คุณต้องอนุมัติ เครื่องมือ AI ด้านความปลอดภัยส่วนใหญ่ส่งข้อมูลเหล่านี้ไปยังผู้ให้บริการโมเดลในต่างประเทศ ซึ่งคุณมองไม่เห็นและควบคุมไม่ได้
โมเดลของ Netwalker รันบนฮาร์ดแวร์ที่เราเป็นเจ้าของ ภายในเครือข่ายที่ได้รับการรับรอง ISO/IEC 27001 ในประเทศไทย ไม่มีข้อมูลถูกส่งไปยัง OpenAI, Anthropic หรือ Google และยังช่วยให้คุณประหยัดเวลาได้หลายเดือน เพราะไม่ต้องทำ review การโอนข้อมูลข้ามประเทศ ไม่ต้องยื่นเรื่อง cloud outsourcing และไม่มีผู้ให้บริการรายใหม่ให้หน่วยงานกำกับต้องตรวจสอบ
ทุกช่องโหว่ผ่านการพิสูจน์ และมีคนลงชื่อรับรอง
- ไม่มีช่องโหว่ที่แต่งขึ้น: ช่องโหว่จะนับก็ต่อเมื่อปรากฏใน response จริงที่บันทึกจากระบบของคุณ agent รายงานได้เฉพาะสิ่งที่เป้าหมายตอบกลับมาจริง
- ทำซ้ำได้: ทุกรายการมี proof of concept ทีละขั้นตอนพร้อมวิธีแก้ ทีมของคุณจึงลงมือแก้ได้ทันที ไม่ต้องมาตรวจซ้ำ
- มีผู้รับผิดชอบ: ทุกรายงานลงชื่อโดยผู้เชี่ยวชาญที่ถือใบรับรองอย่าง OSCP, OSCE, CREST หรือ eWPTX เครื่องไม่เคยเป็นผู้ลงชื่อ
ใช้จริงในงาน pentest ของลูกค้าแล้ว
Netwalker เป็นเครื่องมือมาตรฐานในงานทดสอบเจาะระบบของ MAYASEVEN แล้ว ลูกค้าที่จ้าง MAYASEVEN ทำ pentest ในปี 2569 ทีมของเราจะใช้ Netwalker ช่วยค้นหาช่องโหว่เพิ่มให้ โดยไม่คิดค่าใช้จ่ายเพิ่ม ผู้เชี่ยวชาญของเราตรวจทุกช่องโหว่ซ้ำก่อนส่งรายงาน และระบุชื่อผู้ตรวจไว้ในรายงาน นอกจากนี้ลูกค้ายังได้ใช้ Pentest Management Platform ที่รวมอยู่ในบริการ เป็นศูนย์กลางรับรายงาน ติดตาม และหารือการแก้ไขช่องโหว่อย่างปลอดภัย แทนการส่งข้อมูลผ่านช่องทางที่ไม่ปลอดภัย
ดูภาพรวม การทำงาน และผล benchmark ของ Netwalker แบบสรุปได้ที่หน้า Netwalker
จากเวทีเสวนา: Shift-Left ต้องไปไกลกว่าเดิม
ในช่วงเสวนากับ พล.อ.ต. อมร ชมเชย เลขาธิการ สกมช. ประเด็นที่ตรงกันคือ Shift-Left ต้องพัฒนาเป็น “Super Shift-Left” ตรวจช่องโหว่ก่อนปล่อยซอฟต์แวร์ทุกครั้ง ให้ deploy เฉพาะซอฟต์แวร์ที่ปลอดภัยที่สุด ใช้ SBOM ดูแล dependency การ patch ต้องเร็วขึ้นมาก นโยบายควรเปิดให้ตัดการเชื่อมต่อที่เสี่ยงสูงได้แทบทันที และทีมความปลอดภัยควรใช้ AI ช่วยงานปฏิบัติการเพื่อมีเวลาไปทำนโยบายมากขึ้น แนวคิดนี้คือสิ่งที่เราทำใน MAYASEVEN Left Shift
บทสรุป
11 องค์กรถูกแฮกใน 26 วินาที AI ของผู้โจมตีไม่รอให้ถึงรอบ audit ครั้งถัดไปของคุณ แล้วทำไมคุณต้องรอ?
Machine speed. Human proof. Your data stays home. เลือกพาร์ตเนอร์ที่พิสูจน์ได้ว่า AI ของตัวเองใช้ได้จริง รันบนฮาร์ดแวร์ของตัวเอง และมีผู้เชี่ยวชาญที่มีชื่ออยู่เบื้องหลังทุกช่องโหว่ คุยกับทีม MAYASEVEN เพื่อกำหนดขอบเขตงานทดสอบของคุณ
ดาวน์โหลดสไลด์ keynote ฉบับเต็ม (24 หน้า)Hackers hack with AI. Why don’t we? — PDF 1.1 MB (ภาษาอังกฤษ) ใช้อ้างอิงหรือนำไปเล่าต่อในองค์กรได้แหล่งอ้างอิง
- CrowdStrike 2026 Global Threat Report
- Verizon 2026 Data Breach Investigations Report (พ.ค. 2569)
- IBM Cost of a Data Breach 2025 · Mandiant M-Trends 2026
- SlashNext 2023 · Microsoft Digital Defense Report 2024 · Gartner 2024 · ENISA Threat Landscape 2025
- GreyNoise, “Agents Gone Wild” (9 ก.ย. 2569) · BleepingComputer (10 ก.ย. 2569)
- จดหมายเปิดผนึก 27 ส.ค. 2569 (รายงานโดย Axios, TechCrunch, CBS News)
- จำนวนแพตช์ Microsoft Patch Tuesday รายเดือน (BleepingComputer)
- Chaofan Shou (@shoucccc), “Your Agent Is Mine: Measuring Malicious Intermediary Attacks on the LLM Supply Chain”, arXiv:2604.08407
- Cobalt, AI and Pentesting Pulse Report 2026 · Daniel Stenberg (curl), 26 ม.ค. 2569
- CyberGym leaderboard (cybergym.io), ก.ย. 2569 · Cyber-AutoAgent v0.1.4, arXiv 2607.13085
- TechTalkThai: MAYASEVEN เปิดตัว NetWalker (14 ต.ค. 2569)